eDocArrangement2 ヘルプ
PDF変換処理
PDF変換処理は画像ファイルをPDFファイルに変換します。複数の画像ファイルを1つのPDFファイルに束ねて変換することもできます。
JPEGファイル、PNGファイル、BMPファイルを変換できます。
Version 2.4.8からxdwファイル、xbdファイル、マルチフレームtiffも変換可能となりました。変換後のPDFはページがイメージとなり、テキスト情報は失われます。
Version 2.5.0からPDFも変換可能となりました。テキストを持ったPDFはページがイメージとなり、テキスト情報は失われます。


対象ファイル
「グループ内ファイル」又は、「ファイルを指定する」を選択します。
「グループ内ファイル」を選択した場合、カレントの繰り返し処理のグループ内のファイルを対象に処理を行います。フォルダ内の全ての画像ファイルを1つのPDFに束ねて変換する場合に、「グループ内ファイル」を選択します。「グループ内ファイル」を選択する場合は、以下の様にファイルの繰り返し処理のグルーピングをフォルダにします。

「ファイルを指定する」を選択した場合、指定されたファイルを対象に処理を行います。縦棒区切りで複数指定可能で、「{%GET(FullPathFiles,||)}」を対象にするとグループ内ファイルを選択した場合と同等の処理となります。(ファイルの繰り返し処理のグルーピングをフォルダにする必要あり。)
変換先フォルダ
PDFファイルの変換先フォルダを指定します。実行時に指定されたフォルダが存在しない場合は自動で作成します。マクロを使って日付のフォルダ等を指定できます。
変換先フォルダの入力欄で右クリックメニューを表示できます。マクロを選択すると選択されたマクロが入力欄に貼り付きます。
例えば、「C:\Home\FAX文書\pdf\{%DATE(yyyy)}\{%DATE(MM)}\{%DATE(dd)}」のように記述すると、変換時に「C:\Home\FAX文書\pdf\2016\04\15」のような、年月日をフォルダの階層で作成して、その中にPDFファイルを変換出力することができます。
マクロの詳細は 共通マクロ書式 を参照してください。
ファイル名をリネームする
チェックするとファイル名をリネームするようになります。ファイル名にリネーム後の名前を指定します。
ファイル名をリネーム欄でもマクロが使用できます。ファイル名には必ず拡張子(.pdf)を含めるようにしてください。
例えば、「{%DATE(yyyyMMdd_HHmmss_fff)}.pdf」のように記述すると、「20160415_173110_423.pdf」のように「年月日_時分秒_ミリ秒.pdf」のファイル名が付与されます。
変換先に同名のファイルがある場合
「ファイル名に連番を付与する」、「上書きする」のいずれを選択できます。「ファイル名に連番を付与する」を選択した場合、同名のファイルがある場合はファイルの末尾に「_0001」のように連番が付与されます。

変換後のファイル名をユーザーデータにセットする
チェックすると変換後のファイルのフルパスをユーザーデータにセットします。変換処理終了後にユーザーデータからパスを取得可能になります。
格納されるユーザーデータの名前は変換処理名と番号(常に1)になります。
引数1:処理名 引数2:番号(常に1)
PDF変換1で出力されたファイル名のフルパスをログに出力する例
{%WRITE_LOG(変換後のパス:{%GET_U(PDF変換1,1)})}
圧縮方式
圧縮方式を選択します。圧縮方式は標準(JPEG)、劣化無し圧縮、高画質(JPEG)、高圧縮(JPEG)のいずれかを選択します。
文書が白黒で写真がない場合は「劣化無し圧縮」をお勧めします。ファイルサイズが小さくなり、300dpi以上にすれば画質も高くなります。
変換後解像度
変換後解像度を選択します。「自動」を選択した場合は、変換元のイメージと同じ解像度になります。変換元がアプリケーション文書の場合は指定したdpiで変換が行われます。
「指定する」を選択した場合は、指定したdpiで変換が行われます。
減色
減色の処理方式を選択します。「しない」を選択した場合は、減色処理は行わず変換元のイメージと同じ色数になります。
「256色グレースケール」を選択した場合は、256色グレースケールに変換します。
「白黒高画質(ディザリング)」を選択した場合は、高画質の白黒に変換します。ディザリングを行い、色がグレーでもドットを分散して配置するので、見た目がグレーにみえるようになります。但し、単純な白黒と比べて圧縮率が下がるので、圧縮方式を「劣化無し圧縮」にしてもファイルサイズは少し大きくなります。
「白黒」を選択した場合は、白黒に変換します。画質は下がりますが、圧縮方式を「劣化無し圧縮」にすることでファイルサイズは小さくなります。dpiを高めにすれば画質も高くなります。(変換元がアプリケーション文書の場合)
変換後の用紙サイズ
変換後の用紙サイズは以下を選択できます。
|
種類 |
内容 |
|---|---|
|
イメージと同じ大きさにする オススメ! |
変換元のイメージと同じ大きさでXDW文書を作成します。 |
|
最も近い定型サイズにする(ページにフィット) |
変換元のイメージに、最も近い定型サイズとなるように変換します。用紙サイズの定義は一般的な規格に準じていますが、用紙サイズを定義したファイルを指定することで変更することもできます。 |
|
指定のサイズにする(ページにフィット) |
用紙サイズを指定できます。用紙の縦横を指定しない場合は変換元イメージの縦横を判定して指定の用紙サイズに変換します。 |
用紙サイズ定義ファイルを使用する
変換後の用紙サイズを「最も近い定型サイズにする」にした場合のみ指定可能です。
指定しない場合は、eDocArrangement2のインストールフォルダにあるPaperSize.iniを参照します。
PaperSize.iniは以下のようなフォーマットになっています。(階層ありのタブ区切り)
2A0
	1	841.0
	2	2378.0
A0
	1	841.0
	2	1189.0
A1
	1	594.0
	2	841.0
A2
	1	420.0
	2	594.0
A3
	1	297.0
	2	420.0
A4
	1	210.0
	2	297.0
A5
	1	148.0
	2	210.0
A6
	1	105.0
	2	148.0
B0
	1	1030.0
	2	1456.0
B1
	1	728.0
	2	1030.0
B2
	1	515.0
	2	728.0
B3
	1	364.0
	2	515.0
B4
	1	257.0
	2	364.0
B5
	1	182.0
	2	257.0
B6
	1	128.0
	2	182.0
はがき
	1	100.0
	2	148.0
用紙サイズ定義ファイルを使用する場合は、eDocArrangement2のインストールフォルダにあるPaperSize.iniをコピーして、ログインユーザーがアクセス可能な場所に配置して使用してください。(インストールフォルダのPaperSize.iniは編集しないでください)
変換元PDFファイルのアンチエイリアス
入力ファイルがPDFの場合はPDFをイメージに変換してから新しいPDFを出力します。
アプリケーションPDFをイメージPDFに変換できます。但し、テキストを持ったPDFでもイメージになりますので、テキストは失われます。
イメージに変換する際のテキストやパス(罫線など)のアンチエイリアスを有効・無効にします。画像についてはスムージングの処理を行います。
アンチエイリアスを有効にすると文字や罫線がきれいになりますが、ファイルサイズが大きくなります。特に劣化なし圧縮の場合、無効にした場合と比べて10倍くらいの大きさになる場合があります。
QRコードやバーコード等は画像またはパスで作成されていますが、これらに対してアンチエイリアスを有効にすると輪郭の周囲がぼやけてしまうので、無効にしてください。
バーコードやQRコードがあるPDF帳票や、注文書、請求書などの事務処理で使うPDF帳票等は、圧縮方式を劣化なし圧縮にしてアンチエイリアスはすべて無効、dpi(変換後解像度)を300または400にすることをお勧めします。印刷したときに鮮明でファイルサイズも小さくなります。
テキスト処理
「テキスト処理」タブでは、変換したPDFのイメージの上に見えない文字(透明テキスト)を重ねて、検索・選択・コピーできるPDFにする設定を行います。DocuWorks文書のテキストを重ねる設定と、深層学習OCRで読み取った文字を重ねる設定があります。(Version 2.7.1から。Version 2.7.0の「DocuWorks文書のテキストを文字の層(透明テキスト)として重ねる」は「オプション」タブにありました)
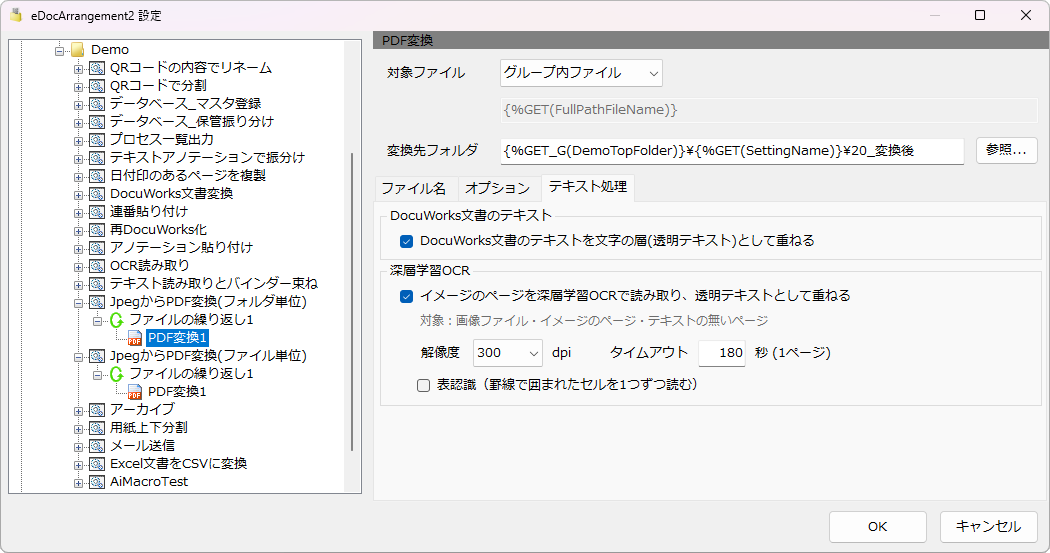
DocuWorks文書のテキストを文字の層(透明テキスト)として重ねる
入力ファイルがDocuWorks文書(XDW・XBD)の場合に、ページのテキストを、イメージの上に見えない文字(透明テキスト)として重ねます。PDFの見た目はイメージのままで、PDFの中のテキストを検索・選択・コピーできるようになります。(Version 2.7.0から)
文字の位置は、DocuWorks文書のテキストの位置をそのまま使います(OCRは行いません)。変換後の用紙サイズに合わせてイメージを拡大・縮小した場合も、同じ倍率で文字を置きます。
次のページには文字の層を重ねません。
テキストを持たないページ(スキャンしたイメージのページなど)
テキストを持っていても、文字の位置が取得できないページ(DocuWorks Printerで作成した文書の一部など)
イメージファイルやPDFから作成したページ
これらのページにも文字を重ねる場合は、下の「イメージのページを深層学習OCRで読み取り、透明テキストとして重ねる」をチェックしてください。
ログには「文字の層: 3/4ページ」のように、文字の層を重ねたページの数と、DocuWorks文書から作成したページの数を出力します。文字の位置が取得できないため重ねなかったページがある場合は、その数も出力します。
付箋などのアノテーションの文字は文字の層に入りません(ページのテキストだけを重ねます)。アノテーションの文字を検索に使う場合は、DWアノテーション取得で読み取って、文書属性やデータベースに残してください。
文字の位置を取得するため、文字の層を重ねない場合より変換に時間がかかります。時間はページの文字の数に比例します(弊社の試験では、約630文字のページで1ページあたり約1秒、130~150文字のページで約0.2~0.5秒増えました)。
イメージのページを深層学習OCRで読み取り、透明テキストとして重ねる
イメージのページを深層学習OCR(PaddleOCR)で読み取り、読み取った文字を見えない文字(透明テキスト)として重ねます。スキャンした文書やFAXなど、テキストを持たないページも、検索・選択・コピーできるPDFになります。チェックしない場合(既定)は読み取りません。(Version 2.7.1から)
読み取るページは次のとおりです。
|
変換元 |
読み取るページ |
|---|---|
|
画像ファイル(TIFF・JPEG・PNG・BMP) |
すべてのページ |
|
DocuWorks文書(XDW・XBD) |
イメージのページ(DocuWorksのOCRのテキストを持っていても、深層学習OCRで読み取ります)と、テキストを持たないページ、文字の位置が取得できないページ |
|
|
テキストを持たないページ(スキャンしたPDFのページなど)。テキストを持つページは読み取りません(テキストは失われます) |
「DocuWorks文書のテキストを文字の層(透明テキスト)として重ねる」と両方をチェックした場合、テキストを持つDocuWorks文書のページにはDocuWorks文書のテキストを、上の表のページには深層学習OCRで読み取った文字を重ねます。1つのページに両方を重ねることはありません。
解像度は、DocuWorks文書とPDFのページを読み取るときに、ページを画像にする解像度です。150~600dpiから選択します(既定は300dpi)。変換後解像度とは別に指定できます。画像ファイルは、変換に使う画像(減色の前)をそのまま読み取ります。
タイムアウトは、1ページの読み取りを待つ上限の秒数です。10~3600の整数で指定します(既定は180秒)。
表認識をチェックすると、表の罫線を見つけ、罫線で囲まれたセルを1つずつ読み取ります。表の1行が1行のまま並び、セルの間には空白が入るので、表の行を検索・コピーしやすくなります。罫線の無い表は、表として認識されません。横の点線の罫線(FAXの明細の行の区切りなど)も罫線として扱います(縦の点線は扱いません)。読み取りの時間は約2倍になります。チェックしない場合(既定)は、表認識をしません。
読み取った文字は、変換後の用紙サイズに合わせてイメージを拡大・縮小した場合も、イメージの文字の位置に重ねます。
重ねる文字のうち、康熙部首・CJK部首補助・CJK互換漢字の3字(漣・煉・溺)は同じ字形の普通の漢字に、半角の円記号(U+00A5)は円記号(U+005C)にします(DocuWorks文書のテキストの文字の層も同じです。Version 2.7.1から)。
ログには「深層学習OCR: 3/4ページ」のように、文字を重ねたページの数と、読み取ったページの数を出力します。文字が読み取れなかったページ(白紙のページなど)がある場合は、その数も出力します。表認識をチェックした場合は「深層学習OCR: 3/4ページ 表: 5」のように、見つけた表の数も出力します。
深層学習OCRを使うには64ビットのWindowsが必要です(深層学習 OCR(PaddleOCR)について)。読み取りには1ページあたり1~3秒程度かかります(弊社の試験では、A4・300dpiのページで約1~2.5秒)。OCRで読み取った文字には誤りが含まれることがあります。
読み取った文字を位置付きのデータとして使う場合は、マクロ PDF_OCR_TEXT・DW_OCR_TEXT を使ってください。
ファイル毎にPDF変換する場合
ファイル毎にPDF変換を行う場合は、ファイルの繰り返し処理のグルーピングは「なし(ファイル)」を選択します。

対象ファイルは「ファイルを指定する」を選択し、入力ファイルのパスを取得するマクロ「{%GET(FullPathFileName)}」を入力します。(Version 2.4.8から初期表示されるようになりました。)

